本 blog 介绍我们的论文 Beyond Quadratic Loss: The Stability Phase Diagram of Adam,主要回答以下三个问题:
- Adam 的 beta settings 如何决定训练是平稳的,还是反复出现 loss spikes?
- 这些 phase 的分界告诉了我们怎样的 loss landscape?
- 这种 loss landscape 为什么会自然出现在 confident cross-entropy(CE)训练中?
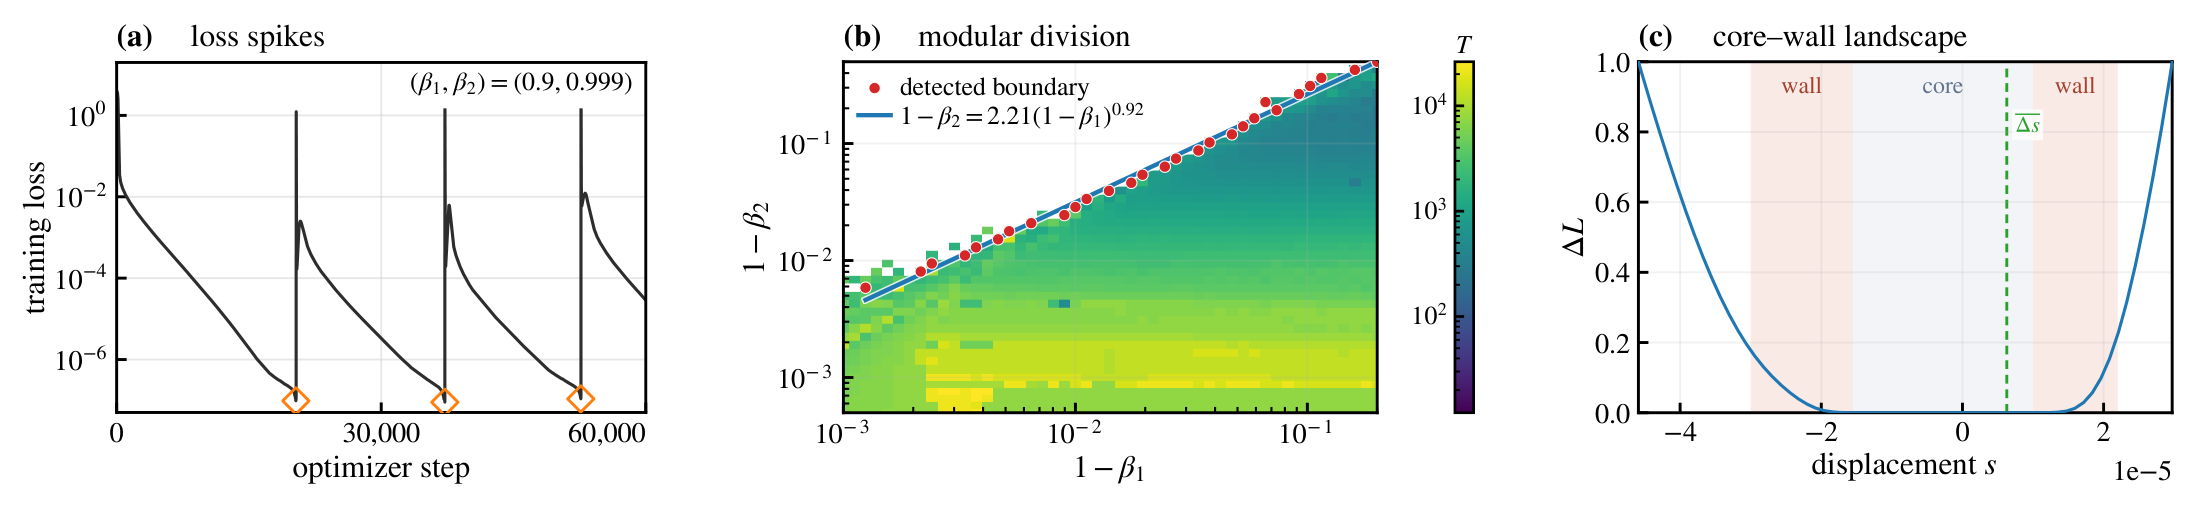
图 1 · Adam loss spikes、phase diagram 与 core–wall landscape
上图给出这项工作的完整图景:(a) modular-division Transformer 的训练 loss 周期性出现 spikes,橙色菱形标记 spike 前的低 loss 点。(b) 在 \((\beta_1,\beta_2)\) settings 上,spiky 与平稳训练之间存在清晰的 phase boundary,颜色表示振荡周期。(c) Spike 前的 loss landscape 呈现狭窄的 core 与陡峭的 wall,绿色虚线标记典型更新尺度。
Adam 的 beta settings 如何决定训练是平稳的,还是反复出现 loss spikes?
Adam 的 \(\beta_1\) 和 \(\beta_2\) 分别控制梯度一阶矩与二阶矩的记忆时间。它们越接近 1,记忆时间越长,分别约为 \(1/(1-\beta_1)\) 和 \(1/(1-\beta_2)\)。这两种记忆时间如何配合,决定了训练过程中是否会反复出现 macroscopic loss spikes。
我们首次在真实模型训练中系统观察到 Adam 在 beta settings 上的 phase boundary。 我们用 AdamW 训练六组模型与任务:modular division 和 modular addition 的 Transformer、Tiny Shakespeare 的字符级 Transformer、CIFAR-10 的 MLP 和 CNN,以及 MNIST autoencoder。在每组实验中,只改变 \(\beta_1,\beta_2\),就能观察到 spiky 与平稳训练之间的近线性分界:
\[1-\beta_2\simeq C(1-\beta_1).\]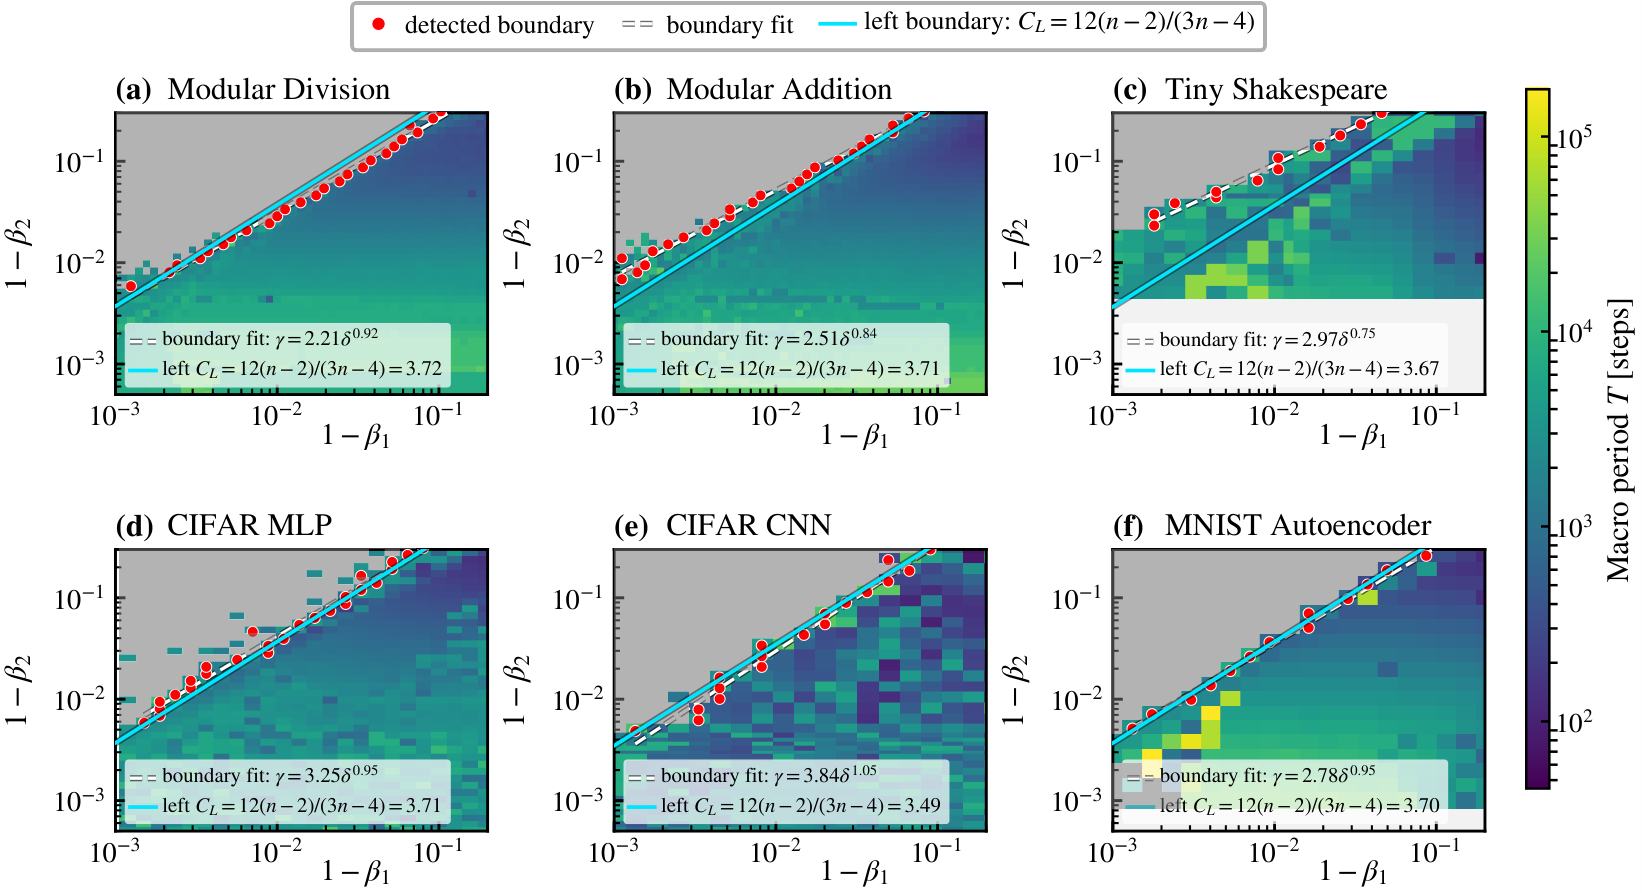
图 2 · 六组模型的 Adam phase diagram
红点标记 phase boundary,白色虚线为幂律拟合。固定 \(\beta_1\) 时,较大的 \(\beta_2\) 对应 spiky 一侧,振荡周期也随 \(\beta_2\) 接近 1 而增长。不同模型共同呈现这一规律,说明两种记忆时间的相对比例是理解 Adam spikes 的关键。
这些 phase 的分界告诉了我们怎样的 loss landscape?
为理解这个规律,我们先让 Adam 在一维 quadratic loss 上运行,再把 loss 改为 superquadratic 的幂律形式。两者给出明显不同的标度:
\[\begin{aligned} L(x)\propto x^2 &: \quad 1-\beta_2\propto(1-\beta_1)^3,\\ L(x)\propto |x|^n,\quad n>2 &: \quad 1-\beta_2\propto(1-\beta_1). \end{aligned}\]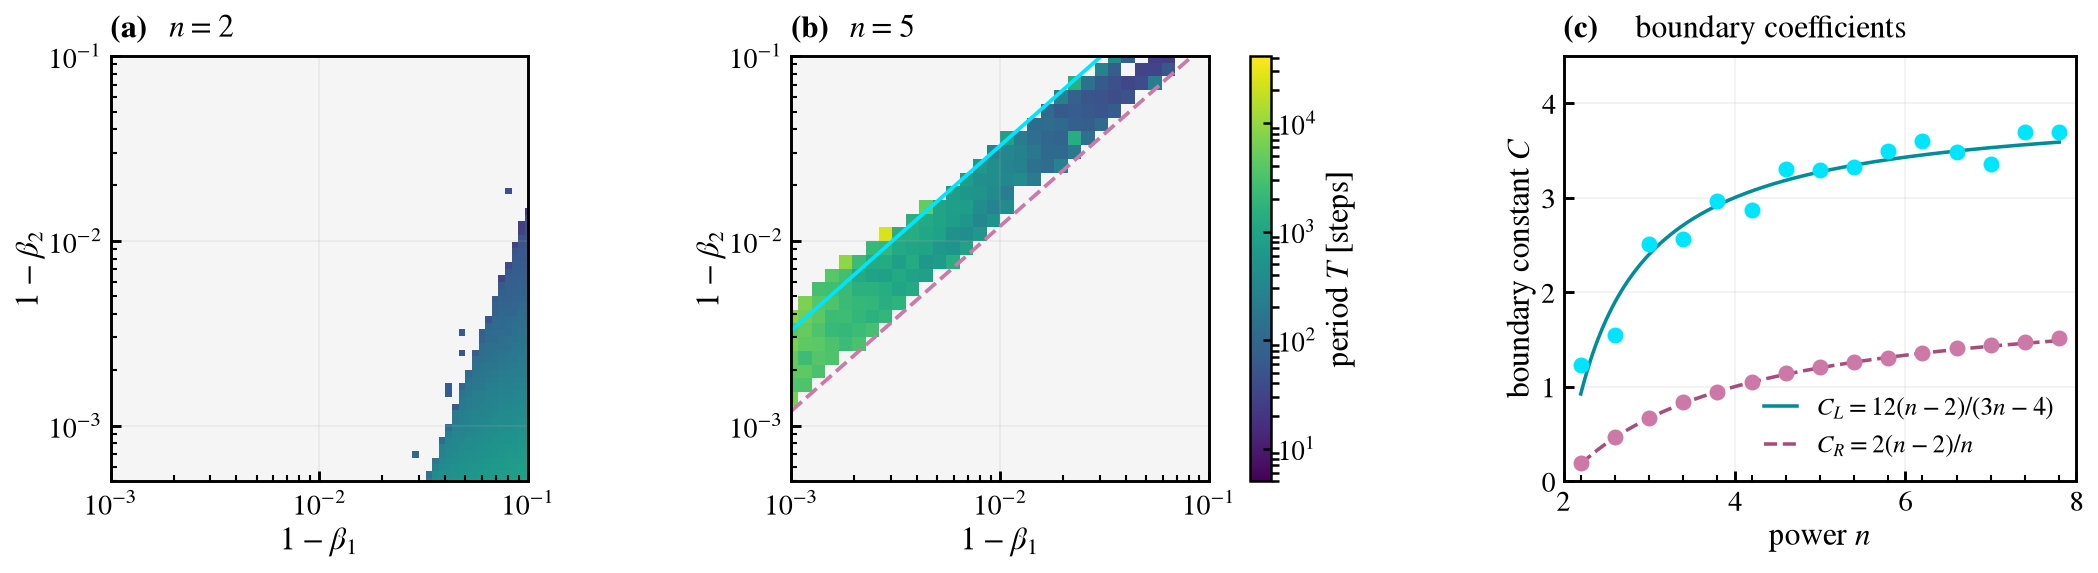
图 3 · Quadratic 与 superquadratic loss 的 phase boundary
上图 (a)、(b) 分别对应 \(n=2\) 与 \(n=5\),(c) 展示分界系数随 \(n\) 的变化。真实模型中的近线性 phase boundary,指向 Adam 更新尺度上的 non-quadratic loss landscape。
沿 Adam-preconditioned gradient direction 查看真实模型的 loss slice,我们观察到 core–wall landscape:中心是平坦而狭窄的 quadratic core,外侧是陡峭的 superquadratic wall,更远处出现增长放缓的 rollover。随着训练推进,core 收缩到典型更新尺度,Adam 开始探索 wall,感受到较大的有效 loss exponent。开篇图 (c) 展示了这一几何结构。
我们在 spike 前测量 wall 的有效指数 \(n\),六组模型的结果约为 \(6.5\)–\(10.9\)。将它代入 toy model 的经验关系
\[C_L(n)\simeq\frac{12(n-2)}{3n-4},\]就能估计真实模型 phase boundary 系数的量级。六模型图中的青色直线展示了这些估计,把 loss landscape 与 beta settings 上的 phase diagram 直接联系起来。
这种 loss landscape 为什么会自然出现在 confident CE 训练中?
Confident CE 指模型已经对正确答案非常确信的训练状态。此时,正确类别与错误类别之间的 logit margin 很大,loss 很低。记第 \(i\) 个样本的正确类别为 \(y_i\),它相对于错误类别 \(j\) 的 margin 为 \(m_{ij}(s)\),其中 \(s\) 是沿固定参数方向的位移。将 margin 局部展开为 \(m_{ij}(s)\simeq m_{ij}-a_{ij}s\),CE 就得到如下指数求和形式:
\[\begin{aligned} L_{\rm CE}(s)&=\frac{1}{N}\sum_i\log\left(1+\sum_{j\ne y_i}e^{-m_{ij}(s)}\right),\\ L_{\rm conf}(s)&\simeq\frac{1}{N}\sum_i\sum_{j\ne y_i}e^{-m_{ij}+a_{ij}s}. \end{aligned}\]这里 \(N\) 是样本数,\(a_{ij}\) 描述 margin 沿该方向的变化。大的正 margin 通过 \(e^{-m_{ij}}\) 压低 loss,位移则通过 \(e^{a_{ij}s}\) 放大部分贡献,使 loss 迅速上升。平坦的 core 与陡峭的 wall 自然起源于 confident CE 的指数结构。
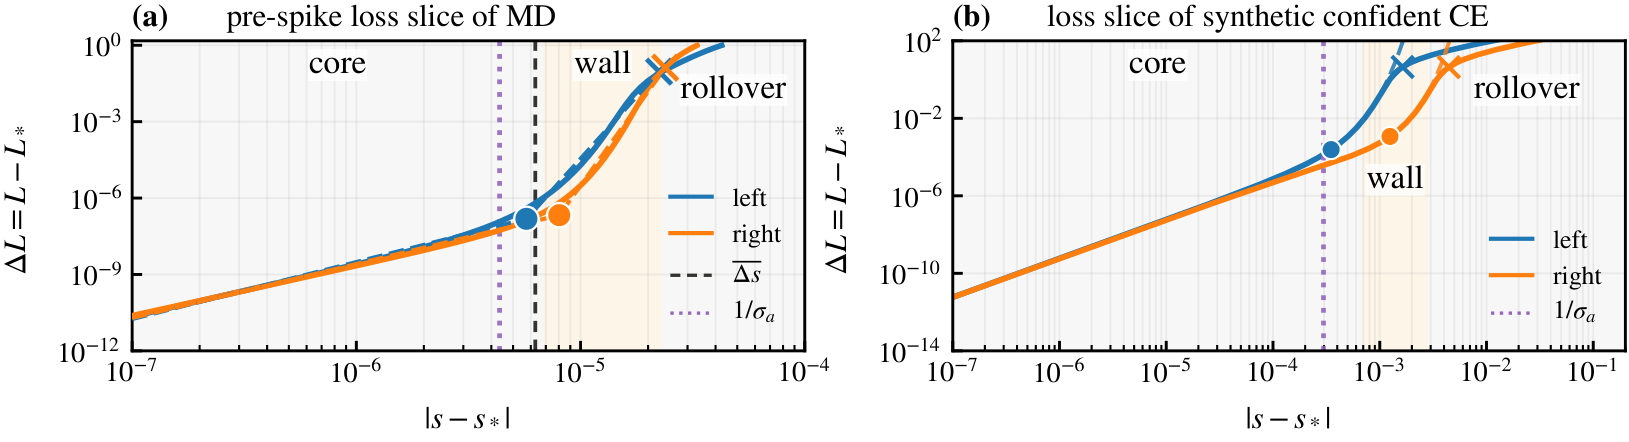
图 4 · 真实模型与 confident CE 的 core–wall landscape
左图是真实模型 spike 前的 loss slice,右图由 synthetic confident CE 直接构造,两者都呈现 core、wall 和 rollover。在 CE-weighted directional margin slopes 的 Gaussian approximation 下,分布宽度 \(\sigma_a\) 决定 quadratic core 的尺度:\(s_{\rm core}\sim1/\sigma_a\)。离开 core 后,指数项快速增长,产生 superquadratic wall。更远处,exact CE 中的 logarithm 使增长放缓,形成 rollover。
在左图的真实模型中,\(1/\sigma_a\simeq4.35\times10^{-6}\),典型更新约为 \(6.3\times10^{-6}\)。一次更新就能跨出 quadratic core,触及陡峭的 wall。这把 confident CE 的形式、有限尺度的 loss geometry,以及 Adam 的训练 phase 连成了一条完整的机制链。
Outlook
这项工作带来两个自然的问题:
- 能否让 optimizer 在自己的更新尺度上估计有效 loss exponent,并据此调整 learning rate 或 \(\beta_1,\beta_2\)?
- 训练过程中,margin 及其 directional slopes 如何演化,并推动 core 收缩与有限尺度的 progressive sharpening?