这篇 blog 旨在为 quantum error correction(QEC)decoder 领域的入门者提供一个 quick overview。内容基于我于 10 月 9 日在叉院量子方向理论讨论组所做的报告,主要分为三部分:conventional decoders、machine learning decoders 和 online decoding。报告的 slides(PDF) 可供下载。
1. Decoder 的任务
先统一三个术语。Mechanism 是候选错误机制及其对应的二值变量,在文献中也称为 error、error mechanism 或 variable。\(x_i=1\) 表示第 \(i\) 个 mechanism 发生,\(x_i=0\) 表示未发生。\(x\) 是全部 mechanisms 的构型,\(p_i\) 是第 \(i\) 个 mechanism 的 prior probability。
Detector 是用于检测错误的校验量。在重复 syndrome extraction 中,它通常是同一 stabilizer 在相邻两轮的 syndrome 测量结果的模 2 差分。若 \(m_{c,t}\) 表示第 \(t\) 轮对 stabilizer \(c\) 的 syndrome 测量结果,则 \(s_{c,t}=m_{c,t}\oplus m_{c,t-1}\)。\(s_a=1\) 表示第 \(a\) 个 detector 被触发,\(s_a=0\) 表示未触发,\(s\) 是全部 detectors 的取值向量。下文将 detector event 或 detection event 统一称为“触发的 detector”。Logical 是所跟踪的逻辑可观测量,\(\ell_\alpha=1\) 表示第 \(\alpha\) 个 logical 发生翻转,\(\ell\) 是全部 logical 的翻转向量。
Mechanisms 对 detectors 和 logical 的影响分别由二元线性映射 \(H\) 和 \(A\) 描述。以下等式在 \(\mathbb F_2\) 上成立:
\[Hx=s,\qquad \ell=Ax.\]以输出 mechanism 构型的 decoder 为例,它接收 \(p,s,H\),寻找满足 \(H\hat x=s\) 的构型 \(\hat x\)。满足 detector 约束只说明这个构型能解释观测。纠错成功还要求 \(A\hat x=\ell\),也就是预测的 logical 翻转与真实翻转一致。本文用 \(d\) 表示 code distance,用 \(s\) 表示 detector 向量。
\(H\) 也定义了一个无向二部图,称为 Tanner graph:每一行对应一个 detector 节点,每一列对应一个 mechanism 节点,\(H_{ai}=1\) 表示两者之间有一条边。对于 low-density parity-check(LDPC)code,这个图是稀疏的。许多高性能 quantum LDPC(qLDPC)code 的构造利用了 expander 的性质,其连接具有 nonlocal 特征,难以在二维平面上仅用局域连接实现。连接结构对 code 性能的限制可参考 baspin2021。
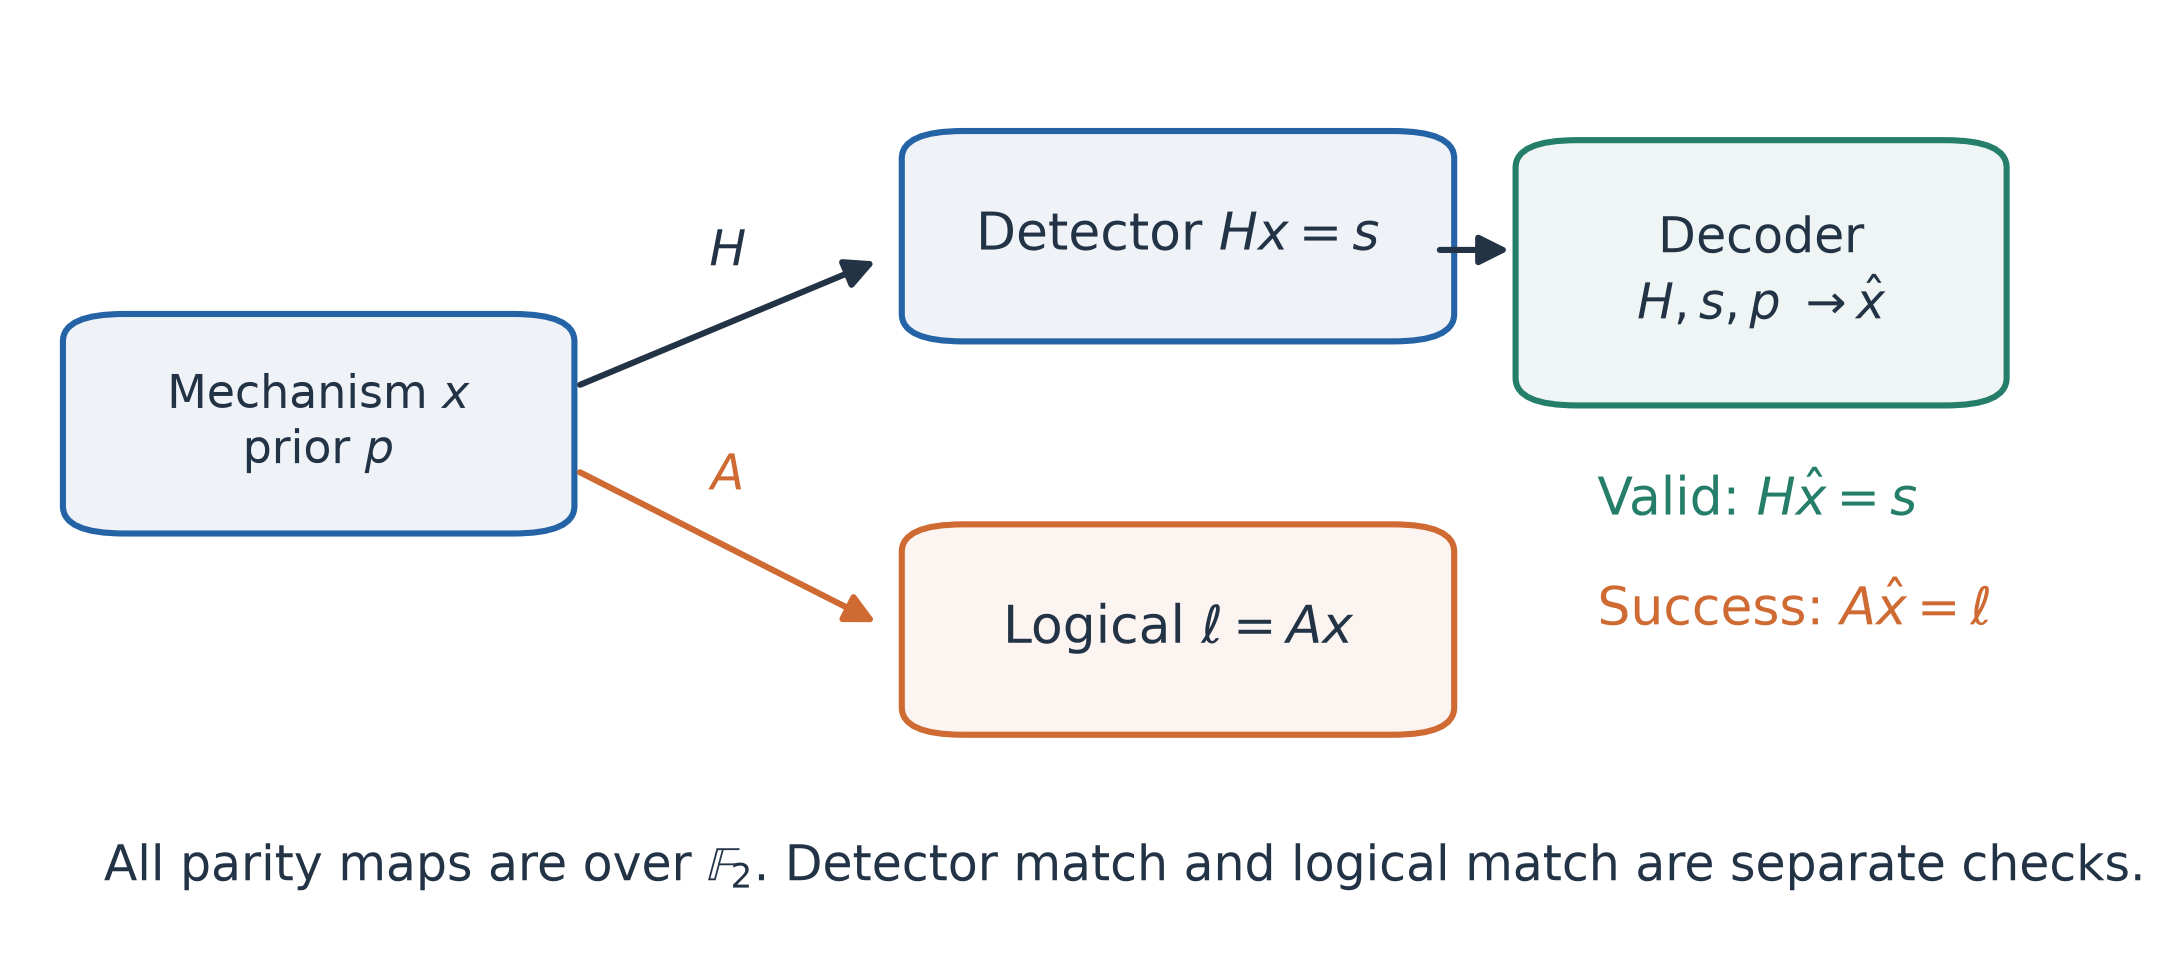
图 1 · Decoder 的输入与目标
Noise model 决定我们使用什么 mechanisms。Circuit-level noise 对应线路中的具体错误机制,例如 idle dephasing 导致的 Pauli Z,或者两比特门中的单比特、两比特误差。Phenomenological noise 则只考虑 data mechanism 和 measurement mechanism,分别描述数据错误和测量错误,将多轮纠错中的误差归入这两类。
在固定 \(s\) 下,产生相同 \(\ell\) 的 mechanism 构型属于同一个 logical class。因此,解码有两个不同目标:寻找近似最小权重的 mechanism 构型,或者寻找总概率最大的 logical class。多数 minimum weight perfect matching(MWPM)、belief propagation(BP)和 beam search 方法主要围绕前一个目标展开。后一个目标需要累加同一 logical class 中多个构型的概率,适合讨论量子纠错中的 degeneracy,但实现通常更困难。
2. Conventional decoders
这一节介绍 MWPM、BP 及其后处理方法,以及 Tesseract。其中,Tesseract 的 logical error rate 达到了 state of the art 水平,但速度较慢。RelayBP 的速度相对较快,准确度则略逊一筹。
个人看法: 我认为,以 Tesseract 为参照,经典 decoder 在准确度上的提升空间已经比较有限。比较解码结果与真实构型的似然度会发现,在多数解码失败的样本中,解码结果的似然度反而更高,也就是说,即使找到了最似然构型,也无法纠正这类错误。因而,更多工作可以着眼于缩短解码时间。一种思路是将多个 decoder 分层组合:先使用较弱但快速的 decoder,对未能解码或结果可疑的样本,再调用更强但更慢的 decoder,并逐层升级。在低物理错误率下,多数 shots 中的错误都很 local,几轮 BP 就能处理,只有少数困难构型需要复杂的 decoder。Mitten codes 论文中的 telescoping decoder 就采用了这种思路 bhardwaj2026。
Minimum weight perfect matching
Minimum weight perfect matching(MWPM)速度快,能在 matching 模型内找到总 weight 最小的解,高效实现的代表是 Sparse Blossom higgott2025。它要求每个 mechanism 最多影响两个 detectors,因此适用于 surface code 的 graphlike decoding,通常无法直接用于大多数 qLDPC code。
在这种模型下,每个 mechanism 可以表示为一条连接 detectors 的 weighted edge,只影响一个 detector 的 mechanism 可以连接到 boundary。多个 mechanisms 组成路径,触发的 detectors 位于路径端点。解码因此可以转化为将触发的 detectors 两两配对。
给定一对 detectors,最似然构型 \(x\) 对应于它们之间总 weight 最低的路径。因此,可以先计算触发的 detectors 之间的最短距离,构建 matching graph,再用 Blossom 算法选择总 weight 最低的配对。
令 \(k\) 为当前触发的 detectors 数量,\(n\) 为 detector graph 的节点总数,\(m\) 为边总数。“最短路预处理 + matching”的复杂度上界可写为
\[O\!\left(k(m+n)\log n+k^3\right).\]Sparse Blossom 直接在稀疏 detector graph 上求解,省去了上述最短路预处理。在论文的低错误率 benchmark 中,实际运行时间大致随问题规模线性增长。
Belief propagation
Belief propagation(BP)在 \(H\) 定义的 Tanner graph 上运行。输入的 prior \(p\) 和 detector 观测 \(s\) 分别位于 mechanism 和 detector 节点上。BP 在两类节点之间传递标量消息,将 \(s\) 的信息纳入对各 mechanism 的估计,得到 posterior probability。相关介绍可参考 liu2019。
下面用 \(i,j\) 表示 mechanism 节点,\(a,b\) 表示 detector 节点,\(N(\cdot)\) 表示邻居集合,\(t\) 表示迭代次数。
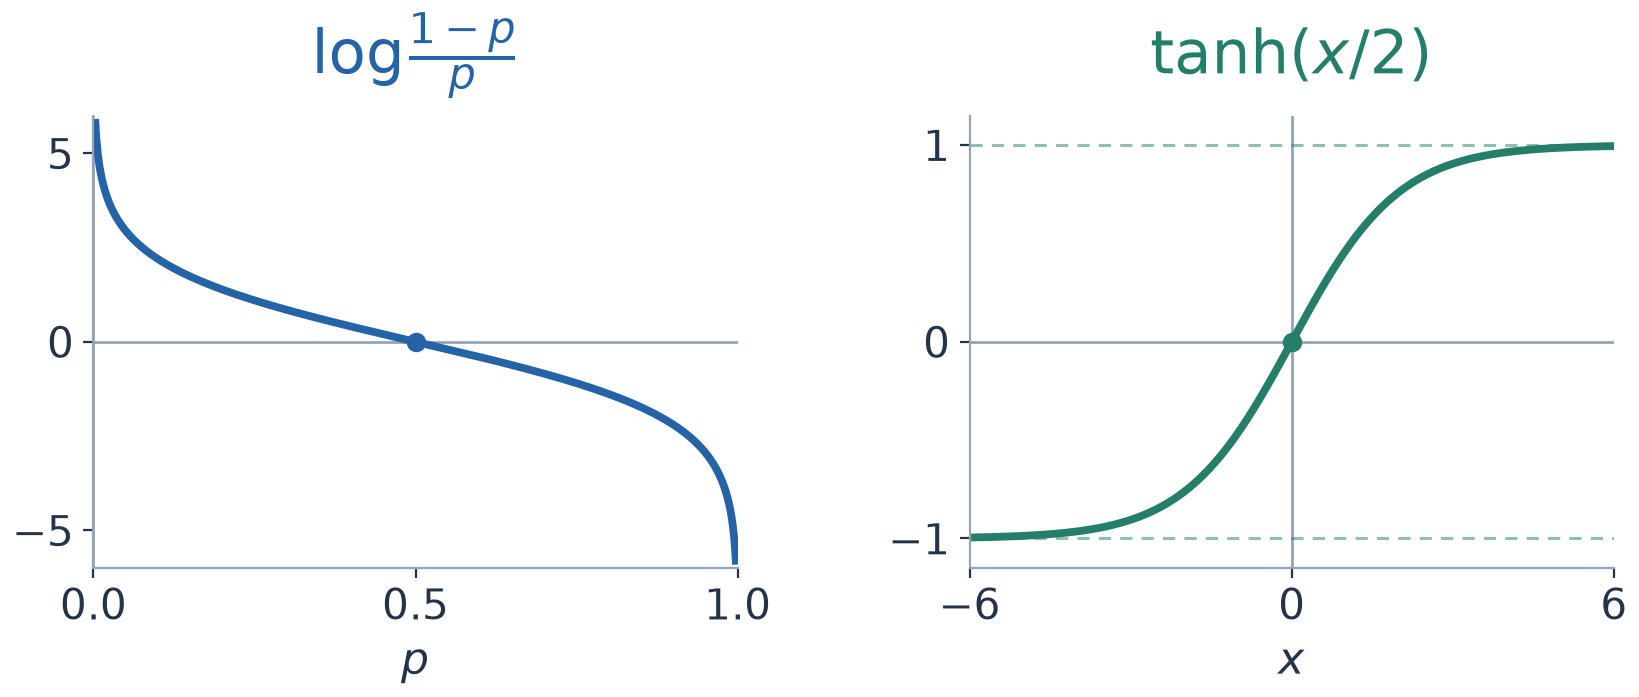
图 2 · BP 更新中的 tanh 与 atanh
-
初始化。 由 prior probability 计算每个 mechanism 的 prior log-likelihood ratio(LLR),并初始化 mechanism → detector 消息:
\[L_i=\log\frac{1-p_i}{p_i},\qquad q_{i\to a}^{(0)}=L_i.\] -
更新 detector → mechanism 消息。 Detector \(a\) 使用其他邻居 mechanisms 的消息,向 \(i\) 传递满足该 detector 约束所需的信息:
\[r_{a\to i}^{(t)}=2\operatorname{atanh}\!\left[(-1)^{s_a}\prod_{j\in N(a)\setminus\{i\}}\tanh\!\left(\frac{q_{j\to a}^{(t-1)}}2\right)\right].\]其中,detector 的观测值通过 \((-1)^{s_a}\) 进入更新。
-
更新 mechanism → detector 消息。 将 prior LLR 与其他 detectors 传来的消息相加:
\[q_{i\to a}^{(t)}=L_i+\sum_{b\in N(i)\setminus\{a\}}r_{b\to i}^{(t)}.\]两种更新都排除了接收方,避免立即将刚收到的信息原样传回。
-
计算 posterior 并做硬判决。 Posterior LLR 包含全部邻居的消息:
\[M_i^{(t)}=L_i+\sum_{a\in N(i)}r_{a\to i}^{(t)}.\]由 \(M_i\) 得到 posterior probability 和硬判决:
\[\widetilde p_i=\operatorname{sigmoid}(-M_i),\qquad \hat x_i=\mathbf 1[M_i<0].\] -
检查 detector 约束。 若 \(H\hat x=s\),则输出 \(\hat x\)。否则令 \(t\leftarrow t+1\),返回步骤 2,直到达到最大迭代次数。普通 BP 的相邻迭代只需继承 \(q\),其余量可以在当轮计算。对于 Calderbank–Shor–Steane(CSS)code,常见做法是分别处理 X、Z 两个部分,得到 \(\hat x_X\) 和 \(\hat x_Z\)。
RelayBP:改变迭代 dynamics。 IBM 提出的 RelayBP 是 BP 类算法中表现较好的一种。它通过带有不同 memory strengths 的多段迭代,缓解普通 BP 的振荡和 trapping sets 问题 muller2025。
蓝色高亮标出相对于上面的 BP 更新发生变化的部分,包括 dynamic bias、MinSum 更新,以及用 \(\Lambda_i^{(t)}\) 替代 \(L_i\)。
-
初始化。 仍使用原始 prior,令 \(q_{i\to a}^{(0)}=M_i^{(0)}=L_i\)。
-
构造 dynamic bias。 用上一轮的 posterior 调整当前轮的 bias:
\[{\color{#0057ff}\boldsymbol{\Lambda_i^{(t)}=(1-\gamma_i)L_i+\gamma_i M_i^{(t-1)}}}.\] -
更新 detector → mechanism 消息。 使用 MinSum 更新:
\[r_{a\to i}^{(t)}={\color{#0057ff}\boldsymbol{(-1)^{s_a}\prod_{j\in N(a)\setminus\{i\}}\operatorname{sgn}\!\left(q_{j\to a}^{(t-1)}\right)\min_{j\in N(a)\setminus\{i\}}\left|q_{j\to a}^{(t-1)}\right|}}.\] -
更新 mechanism → detector 消息和 posterior。 用 dynamic bias 替代原始 prior LLR:
\[q_{i\to a}^{(t)}={\color{#0057ff}\boldsymbol{\Lambda_i^{(t)}}}+\sum_{b\in N(i)\setminus\{a\}}r_{b\to i}^{(t)},\] \[M_i^{(t)}={\color{#0057ff}\boldsymbol{\Lambda_i^{(t)}}}+\sum_{a\in N(i)}r_{a\to i}^{(t)}.\] -
硬判决并检查 detector 约束。 由 \(\hat x_i=\mathbf1[M_i<0]\) 得到硬判决,再检查 \(H\hat x=s\),满足约束时记录候选解。若当前 leg 仍需继续迭代,则令 \(t\leftarrow t+1\) 并返回步骤 2。\(\gamma_i=0\) 时,上述更新退化为 MinSum-BP。
Relay 的含义是将迭代分成多个 legs。每个 leg 内的 \(\gamma_i\) 固定,不同 mechanisms 可以使用不同值,后续 legs 再更换这些值,其中可以包含负值。各 leg 继承上一段的 \(M_i\),但在开头将 \(q\) 重置为原始 \(L_i\),再从步骤 2 开始迭代。如果找到多个合法解,就选择 prior weight 最低的构型。这种方法通过改变 dynamics 帮助迭代离开困住它的区域,可以类比退火的动机。
Post-processing for BP
BP 的后验概率有助于判断哪些 mechanisms 更可能发生,但逐 bit 硬判决不保证满足 \(H\hat x=s\)。后处理算法利用这些后验概率,寻找满足 detector 约束的构型。下面介绍常用的 ordered statistics decoding(OSD)和 localized statistics decoding(LSD),以及我认为很有趣的 best-first ordered statistics decoding(BF-OSD)。
OSD:全局求解。 令 \(r=\operatorname{rank}(H)\),本节用 \(n\) 表示 mechanism 总数,\(k=n-r\)。这里采用 syndrome-based OSD,按照 mechanism 的 posterior probability \(\widetilde p_i\) 从大到小排列 \(H\) 的列 roffe2020。
OSD-0 的步骤是:
- 按排序后的顺序扫描 \(H\) 的列,依次选出 \(r\) 个线性无关列,跳过与已选列相关的列。
- 将基外的 \(k\) 个 mechanisms 设为 0。
- 用高斯消元求解基内 mechanisms 的取值。
当 \(s\) 可由 \(H\) 的列空间解释时,选中的 \(r\) 列构成求解基。固定基外变量后,基内解唯一,并满足 detector 约束。高阶的 OSD-\(w\) 进一步枚举基外至多 \(w\) 个非零 bits 的配置,对每个配置重新求解基内变量,再选择 weight 最低的候选。候选数为
\[N_{\mathrm{cand}}=\sum_{j=0}^{w}\binom{k}{j}.\]候选数随阶数快速增长,因此 \(w\) 通常不能取太大,在较大问题中取到 3 左右就可能难以承受。
LSD:局部 cluster。 LSD 将求解限制在局部 clusters 中 hillmann2025。每个触发的 detector 初始化一个 cluster,然后不断加入与 cluster 相连、posterior probability 最大的 mechanism。增长过程中,如果两个 clusters 相连,就将它们合并。
LSD-0 在局部约束可解、所有触发的 detectors 都得到解释后停止。LSD-\(\mu\) 则在合法 clusters 上继续做至多 \(\mu\) 次额外增长,然后进行局部 OSD。与全局消元相比,局部 clusters 为并行求解提供了空间。
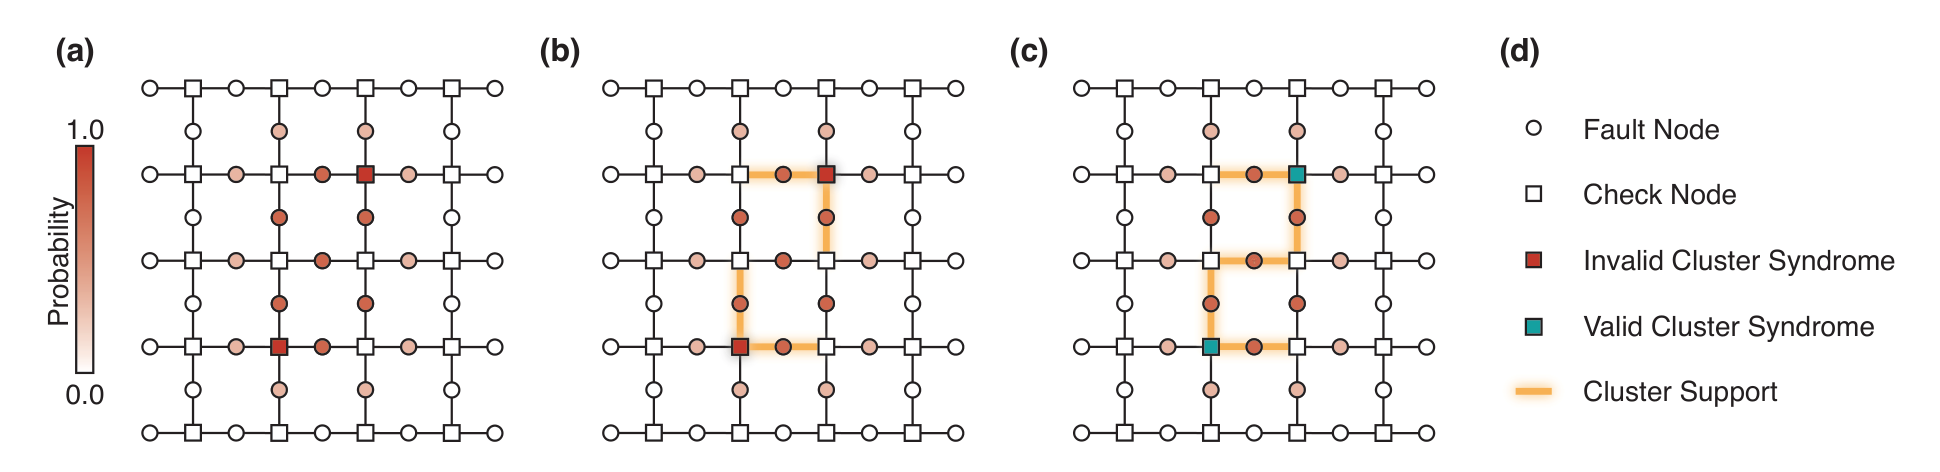
图 3 · LSD cluster 的增长与合并 来源:hillmann2025,Fig. 2。
在足够低的物理错误率下,典型 cluster 的大小不会随 code 规模增长,因此 \(\mu\) 可以取到较大的值,甚至达到 20。在相关 bivariate bicycle(BB)code 测试中,LSD 通常比 OSD 更快,logical error rate 也更低。
BF-OSD:在合法解空间中做 best-first search。 上述两种方法都在 \(x\) 的坐标中进行受 \(Hx=s\) 约束的搜索。不过,所有满足约束的 \(x\) 构成一个仿射空间,选择这个空间的坐标后,就可以直接进行 unconstrained search。
Best-first ordered statistics decoding(BF-OSD)从 OSD-0 的特解 \(x_0\) 出发,用消元得到 \(\ker H\) 的基 \(g_j\) banfi2026。所有满足 \(Hx=s\) 的构型都可以写成
\[x(T)=x_0\oplus\bigoplus_{j\in T}g_j.\]因此,候选生成过程始终留在 \(x_0+\ker H\) 中。生成元 \(g_j\) 表示保持 syndrome 不变的位移。
可以将 BF-OSD 理解为一种似然度优先搜索,其形式类似 Dijkstra 最短路算法。搜索从空集合 \(T=\varnothing\) 开始,用 priority queue 保存候选。每次取出已生成候选中评分最高的 \(T\),检查是否改善当前最优解,然后生成 \(T'=T\cup\{j\}\)。规定 \(j>\max T\),并令 \(\max\varnothing=0\),可以避免重复生成同一组合。Query budget 耗尽后返回已找到的最佳构型。
个人看法: 尽管搜索框架有所创新,BF-OSD 的表现并没有比 LSD 好很多。我认为,一个可能的原因是:Dijkstra 算法中的路径距离随扩展单调增加,而这里的似然度并不随生成元的加入单调变化。如果从初始猜测 \(x_0\) 到最似然构型 \(x\) 必须跨过一个 energy barrier,那么在有限的 query budget 内,搜索可能始终无法越过低评分的中间候选,使最优构型没有机会进入 priority queue。
Tesseract:A* 与 beam search
Tesseract 是一个面向高精度解码的 search-based decoder,将 A* 与 beam search 结合,在论文比较的多类 circuit-level decoding 问题中取得了很低的 logical 翻转率 beni2025。代价是搜索所需的时间和内存需求会高一些。
令 \(F\) 为当前选择的 mechanism 集合,\(s(F)\) 为尚未解释的 detector 向量。\(s(F)=0\) 表示这个构型已经解释了全部观测。使用独立 mechanism prior 时,搜索目标为
\[\min_{F:\,s(F)=0}g(F),\qquad g(F)=\sum_{j\in F}\log\frac{1-p_j}{p_j}.\]从 \(F=\varnothing\) 开始,每次加入一个新的 mechanism \(j\),更新
\[\begin{aligned} F'&=F\cup\{j\},\\ s(F')&=s(F)+H_{\cdot j}\pmod2,\\ g(F')&=g(F)+\log\frac{1-p_j}{p_j}. \end{aligned}\]扩展时,只考虑与编号最小的剩余触发 detector 相连的 mechanisms,并用顺序规则去重。
A* 为每个状态设置优先级
\[f(F)=g(F)+h(F).\]\(g(F)\) 是已经选择的 mechanisms 的代价,\(h(F)\) 是解释剩余 detectors 所需代价的下界估计。Tesseract 将经过适当代价分摊的各 detector 修复代价相加,构造这个估计,并优先探索 \(f(F)\) 小的状态。
Beam 则限制搜索偏离当前进展的程度。令 \(r(F)=\operatorname{wt}(s(F))\),\(r_{\min}\) 为已访问状态中最小的 \(r\),若
\[r(F)>r_{\min}+B,\]就跳过状态 \(F\)。这里的 beam 参数 \(B\) 控制剩余触发 detectors 的允许偏离量。A* 决定先搜索哪些状态,beam 决定保留多宽的搜索范围。
3. Machine learning decoders
Recurrent Transformer
Transformer decoder 的基本组成是 embedding、attention 和 multilayer perceptron(MLP)。Embedding 将 detector 或 data node 的输入映射为特征向量。Attention 根据 node \(a\) 的 query 与 node \(b\) 的 key 的内积,决定 \(a\) 如何聚合 \(b\) 的 value 信息。随后,每个 node 的特征向量独立经过 MLP 演化。
在 QEC 中,空间关系和跨 cycle 的历史需要共同处理。AlphaQubit 使用 recurrent Transformer:将当前 cycle 的 detector 信息 embedding 后加入 hidden state,再通过同一 cycle 内的空间 attention 更新表示,逐轮传递历史 bausch2024。GraphQEC 则在时间方向使用 linear attention 处理历史信息 hu2025。
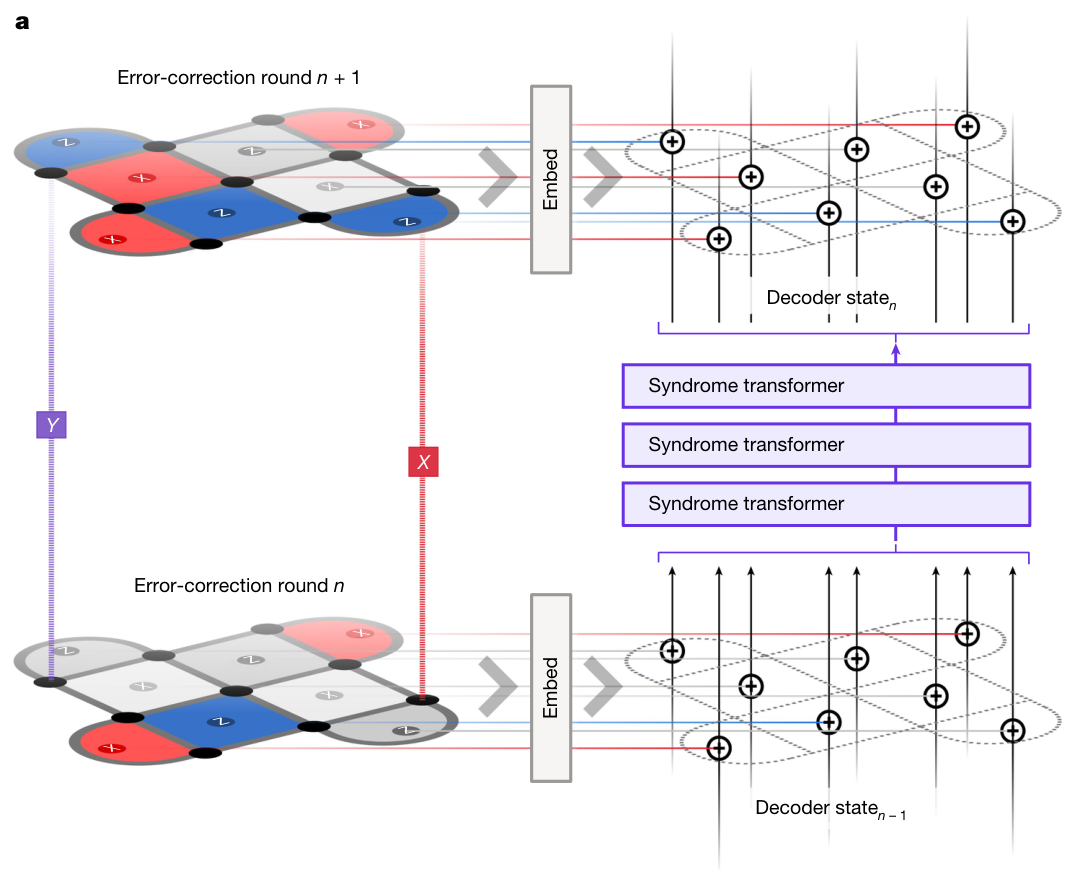
图 4 · AlphaQubit 的 recurrent architecture 来源:bausch2024,Fig. 2a。
这些模型最终预测 logical 翻转。以 AlphaQubit 为例,readout 将 detector hidden states 映射到 data qubit representations,再进行与 logical observable 对应的 pooling 和输出。本文介绍的 Transformer 路线主要采用这种 logical readout,而构型型 decoder 输出的是 mechanism 层面的 \(\hat x\)。
CNN/GNN
这一路线的例子包括在 Tanner graph 上学习 message-passing 的 Astra maan2025,以及通过 convolution 和 residual blocks 处理 detector 信息的 Cascade gu2026。下面以 Cascade 为例。
对具有规则局部几何的 surface code,可以使用 convolutional neural network(CNN)。对 nonlocal LDPC code,则使用由 Tanner graph 邻接关系决定邻居集合的 graph neural network(GNN)。
首先,对每个 spacetime detector \(v=(c,t)\),将其观测值 \(s_v\) embedding 为 \(h_v^{(0)}\in\mathbb R^{D_h}\)。这里用 \(D_h\) 表示 hidden dimension。
随后经过 \(L\) 个 bottleneck residual blocks。每个 block 先将特征从 \(D_h\) 维投影到 \(D_h/4\) 维,在较低维空间中做 convolution,再投影回 \(D_h\) 维,最后加入 residual connection。每次投影或 convolution 前使用 batch normalization(BN)和 sigmoid linear unit(SiLU)activation。
BN 在训练时根据 batch 等统计维度归一化各 feature channel 的 activation,并带有可学习的缩放和偏置。Residual connection 将输入加回当前 block 的输出,使网络能够学习对已有表示的修正。
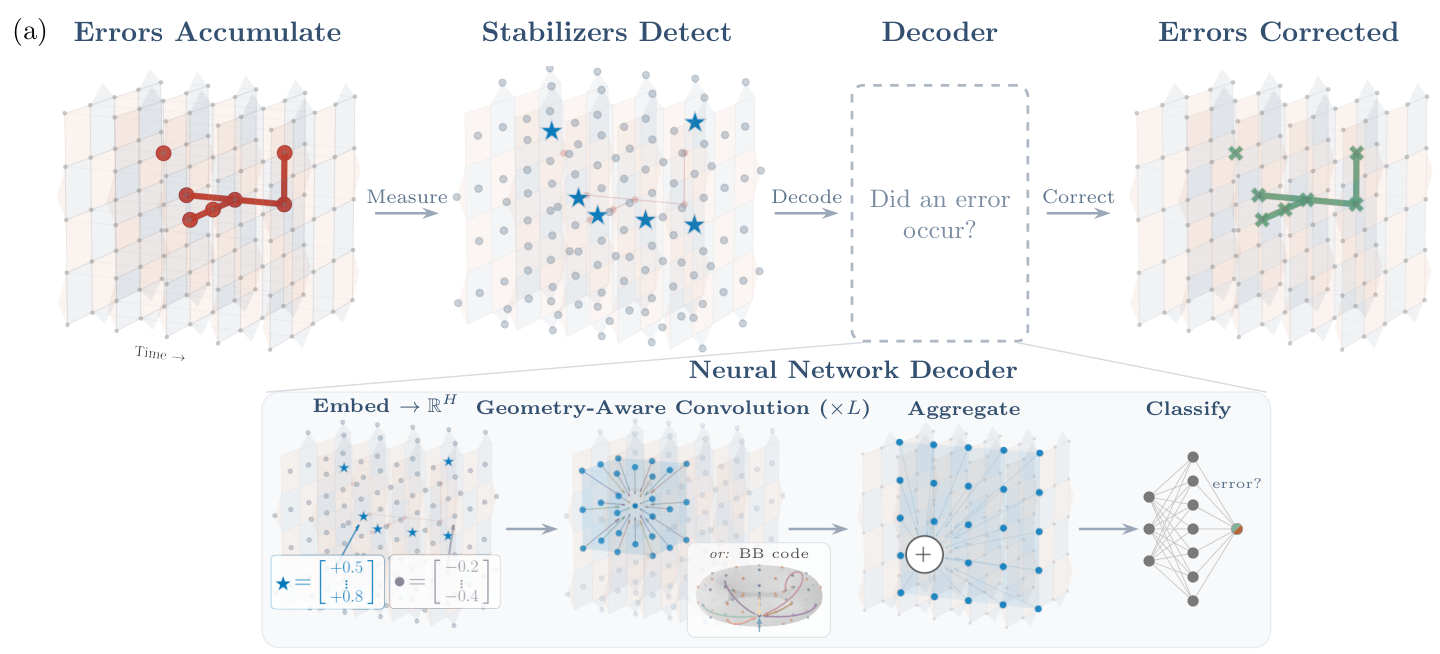
图 5 · Cascade 的网络结构 来源:gu2026,Fig. 1a。
Convolution 的邻居聚合可以写为
\[h_v'=W_{\mathrm{self}}h_v+\sum_{u\in\mathcal N(v)}W_{\delta(u,v)}h_u.\]\(\delta(u,v)\) 表示相对几何或连接关系。具有相同 relation type 的连接共享同一个 \(W_\delta\),因此每条边无需独立矩阵。在局部 surface-code 图上,每层只将 receptive field 扩大常数量级,要让信息传播到 distance \(d\) 的尺度,通常需要 \(O(d)\) 层。
最后,将 detector representations 映射到 data qubits,对 logical operator support 做 pooling,再由 MLP 输出 logical 翻转概率。
个人看法: 需要注意的是,仅输出 logical class,无法提供区分末尾几轮数据错误和测量错误所需的完整信息。例如,在一个 distance 为 \(d\) 的 surface code 中,考虑与两个 X-check 相邻的内部 data qubit。如果最后一轮这两个 checks 的测量结果都出错,观测就可能与该 data qubit 发生 Z flip 相同,在相应 noise model 下,后者甚至可能是更似然的解释。因此,通常只有得到足够后续轮次支持的 Pauli frame 才可靠,而仅输出 logical class 的 decoder 无法提供这一时间信息。对一般的容错量子计算架构而言,这种输出还不够,这也引出了下一节的 online decoding。
4. Online decoders
为什么需要 online decoding?
物理平台的两比特门时间、每个 cycle 的门数和并行度,共同决定 detector 数据的产生速度。要长期运行 QEC,decoder 的均摊处理时间需要小于物理 cycle 时间,否则待解码数据会不断积压。
以 Gross \([[144,12,12]]\) code 为例,它使用 144 个 data qubits 和 144 个 measurement qubits。144 个 weight-6 checks 共需 \(144\times6=864\) 个两比特门 bravyi2024。若将 X、Z checks 分组执行,可以构造 12-layer 示例 schedule,每层 72 个并行门。Google 在超导 surface-code 实验中报告了 1.1 μs/cycle,可作为超导平台的时间量级参考 acharya2024。
离子阱平台的门时间更长。Quantinuum Helios 的原生两比特操作约为 70 μs ransford2026。Gross code 原论文的 Sec. 5 和 Table 5 给出了 7-layer schedule,在充分并行时,峰值为 144 个门同时执行。若将每个 controlled-NOT(CNOT)门的纠缠部分按一次原生 \(R_{ZZ}(\pi/2)\) 操作估计,仅两比特操作就需要 \(7\times70\,\mu\mathrm{s}=0.49\,\mathrm{ms}\),即 490 μs/cycle(仅计两比特操作)。这一预算借用 Helios 的原生门时长进行外推,完整 QEC cycle 还需计入单比特旋转、搬运、冷却、测量和 reset。对于中性原子,代表性架构中的 QEC cycle 预算为毫秒量级 sunami2025。
除了吞吐要求,还需要考虑纠错结果何时能够提交。有测量误差时,单轮观测通常不足以区分数据错误和测量错误,除非采用 single-shot QEC。多轮纠错的最新一轮仍然面临这个问题,需要借助后续数据确定较早轮次的 Pauli frame。
在通常需要 \(O(d)\) 时间冗余的设置中,可以用额外等待约 \(d/2\) 轮来理解这种延迟的量级。因此,online decoder 既要跟上 detector 数据的产生速度,也要在有限延迟内持续输出可提交的 Pauli frame 更新。
Sliding window decoding
Sliding window 是常用的 online decoding 方法 skoric2023。假设初始 boundary 的 Pauli frame 已知,取包含 \(R=2d\) 轮的 window:前 \(d\) 轮作为 commit region,后 \(d\) 轮作为 buffer,为较早轮次提供额外测量信息。Buffer 的末尾缺少后续观测,尚不足以排除测量错误的影响,因此不提交 buffer 中的 Pauli frame 估计。
每次解码整个 window,只提交前 \(d\) 轮的纠错结果。然后将 window 后移 \(d\) 轮,以已提交结果更新 boundary,再重复上述过程。这样,解码可以随着 detector 数据到达而持续进行。
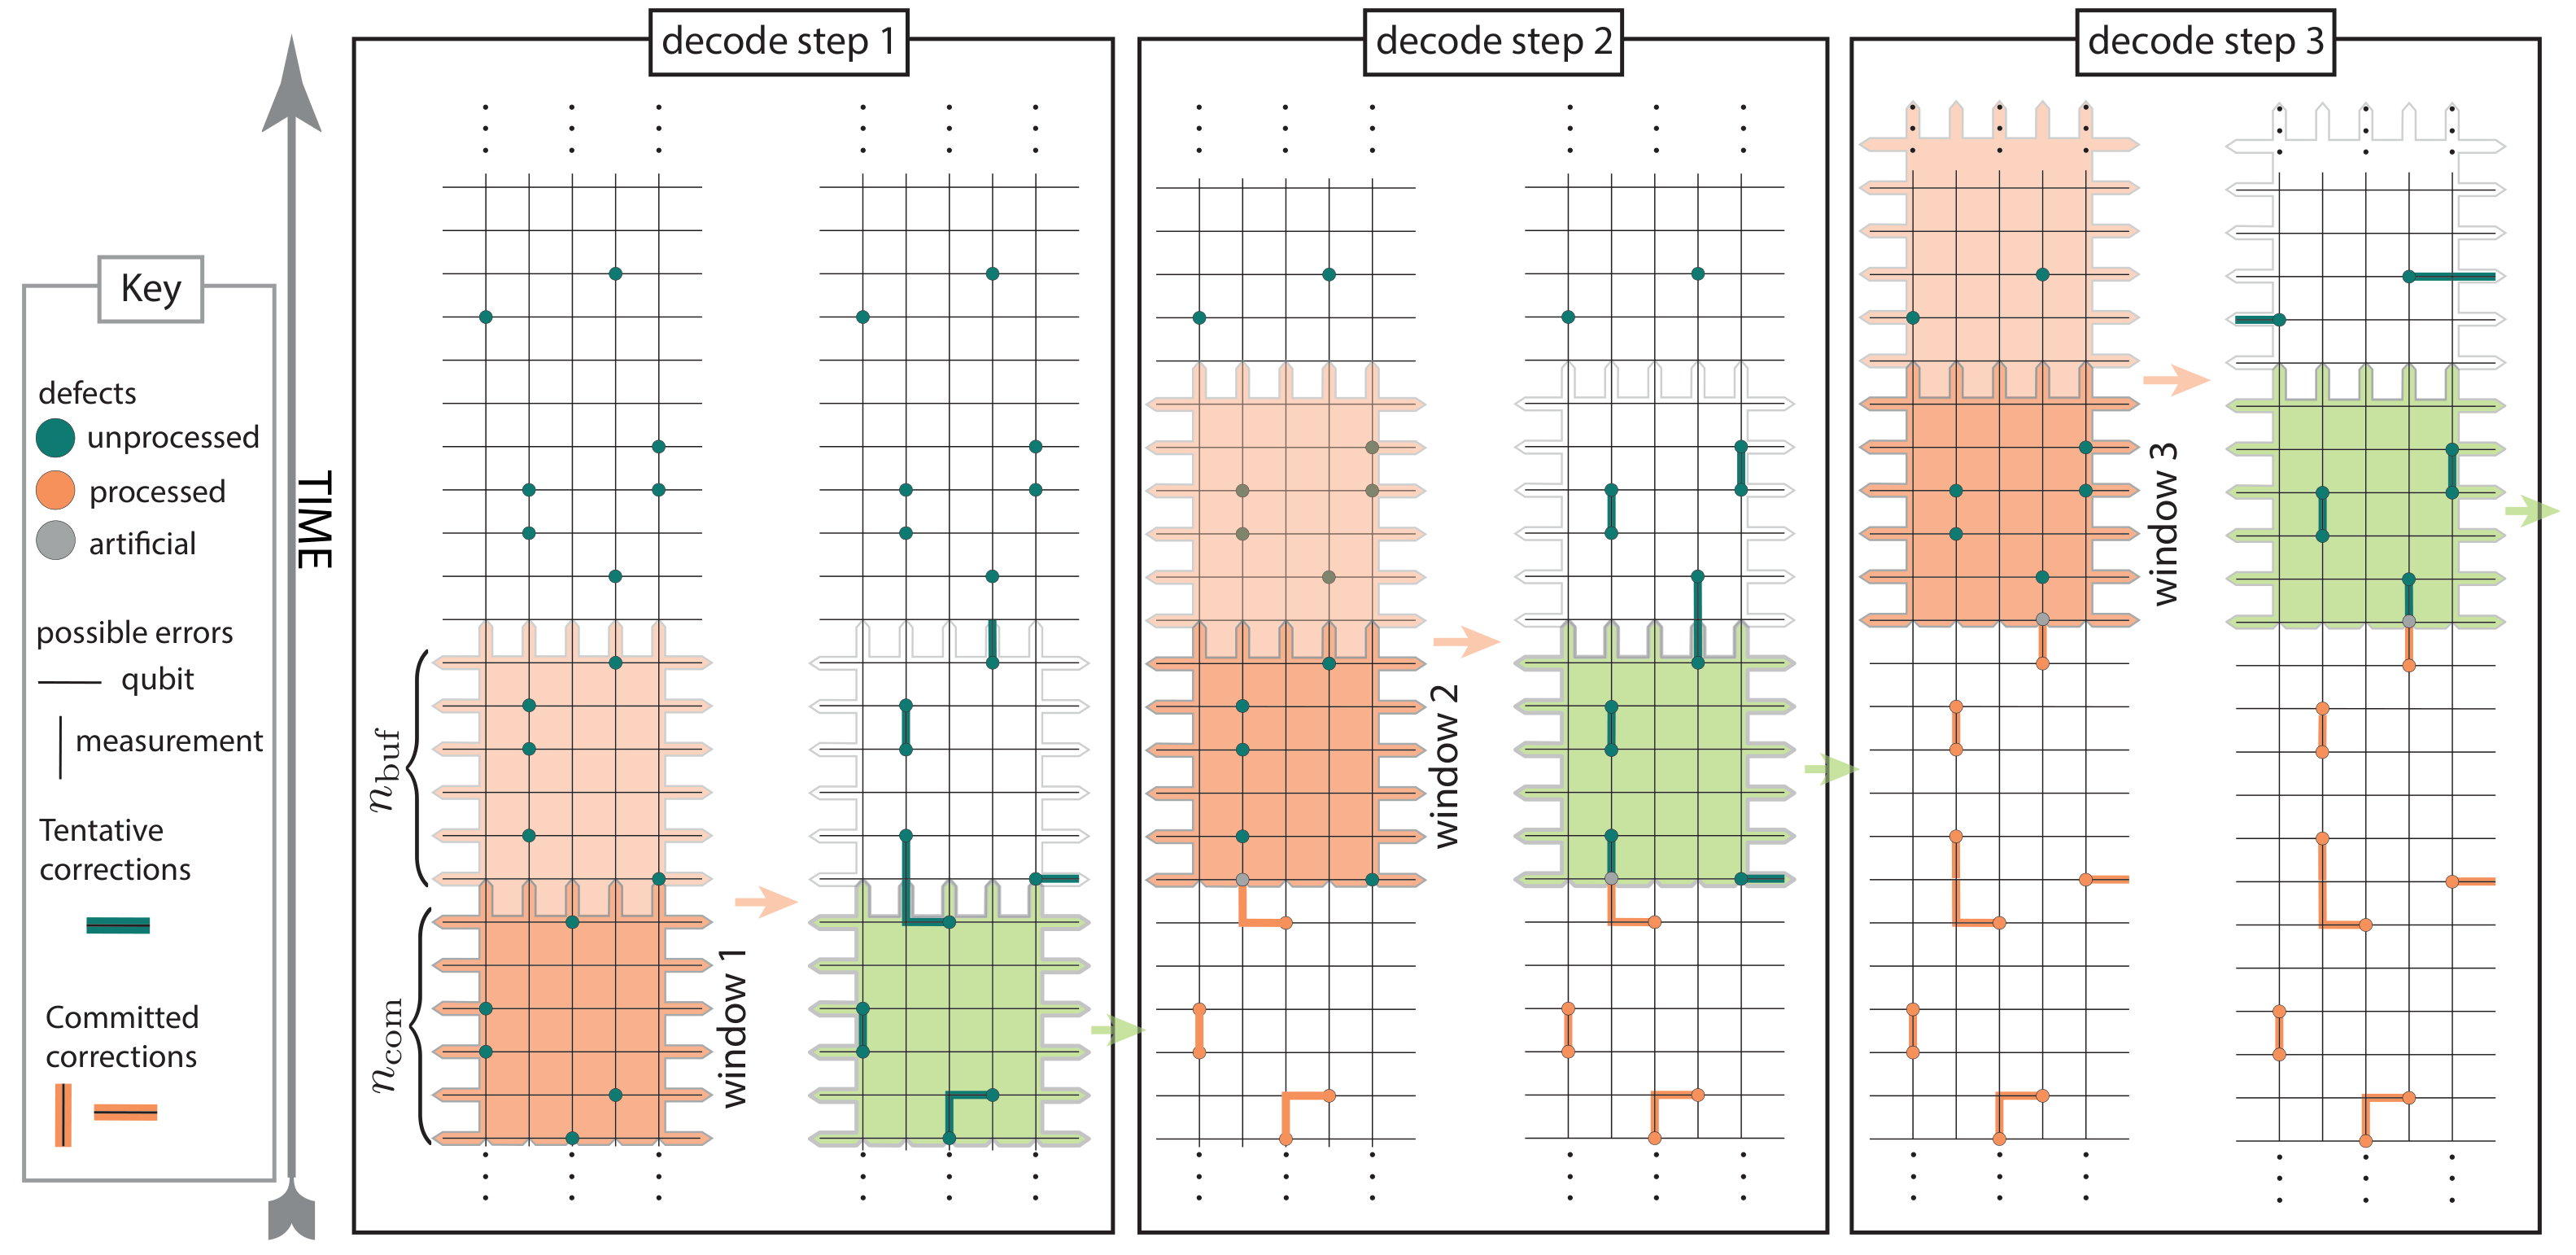
图 6 · Sliding window 的 commit region 与 buffer 来源:skoric2023,Fig. 2。这里采用 \(R=2d\)、每次提交 \(d\) 轮的示例设置。
如果计算资源充足,可以采用 parallel window decoding。第一层将时间序列拆成多个 windows,在前后 buffers 的保护下并行解码并提交各 window 的中间区域。第二层以这些已提交结果为 boundary,再处理剩余区域。通过两层 window,长时间序列的解码可以分配给多个 workers skoric2023。